Wenn niemand mehr hört, wer spricht
Vergleichsstudie: menschliche Narration vs. KI-Produktion
Eine Blindstudie unter 1.005 US-Hörbuchhörer:innen vergleicht menschliche Einzelsprecher-Produktion mit KI-Mehrstimmigkeit. Das Ergebnis fällt differenzierter aus, als beide Lager es sich gewünscht hätten. Und es verschiebt die Frage weg von der Technik hin zum Hörerlebnis.
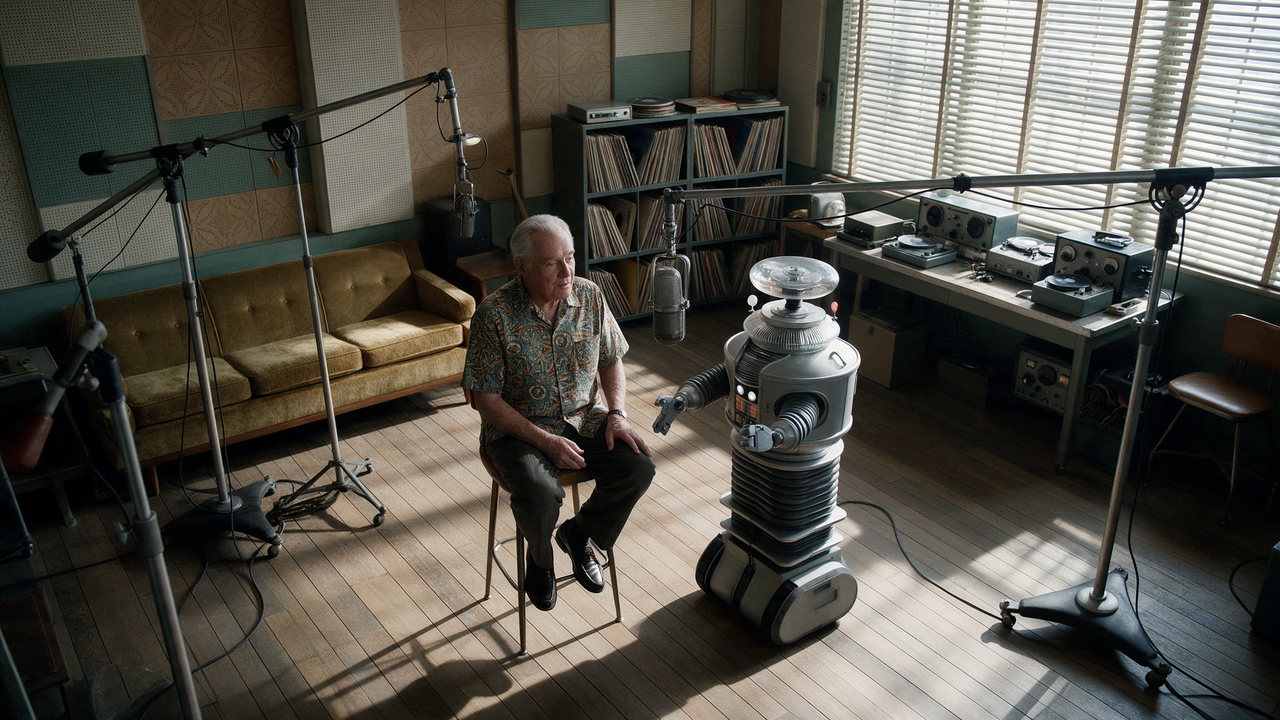
Published: 24.9.2026 | Foto: KI-generiert, Magnific
Edison Research at SSRS hat im Mai 2026 im Auftrag des Anbieters Spoken ("The AI Audiobook Company") 1.005 US-amerikanische Belletristik-Hörbuchhörer:innen ab 18 Jahren online befragt. Die Teilnehmer:innen wurden nach dem Zufallsprinzip in zwei Gruppen aufgeteilt: 502 hörten Ausschnitte aus einem Science-Fiction-Thriller in der Einlesung eines professionellen Sprechers, 503 dieselben Passagen in der mehrstimmigen KI-Produktion "Spoken Multi-Cast". Entscheidend für die Belastbarkeit: Von KI war vor der Bewertung keine Rede. Beide Gruppen wurden demografisch an die Hörbuchnutzer aus dem Infinite Dial 2026 angeglichen und zusätzlich aneinander gewichtet. Weitere Infos zum Studien-Setting.
Was Hörer:innen von Narration erwarten
Noch vor jedem Hörtest zeigte die Befragung eine klare Präferenz für Mehrstimmigkeit. 70 Prozent äußerten Interesse an eigenen Stimmen für jede Figur, 65 Prozent an geschlechtsgleicher Besetzung, 63 Prozent an authentischen Akzenten. Soundeffekte (53 Prozent) und Hintergrundmusik (45 Prozent) folgen mit Abstand. Bei den Vielhörern steigt der Wert für distinkte Figurenstimmen auf 81 Prozent, gut die Hälfte dieser Gruppe ist sogar sehr stark interessiert. Ausgerechnet die intensivsten Nutzer des klassischen Einzelsprecher-Hörbuchs wünschen sich also am deutlichsten etwas anderes.
Interessant für die Vermarktung ist die Rangfolge der Argumente, die eine KI-Produktion akzeptabel machen. Ganz oben stehen bessere Produktionsqualität (51 Prozent) und größere Immersion (49 Prozent). Ein niedrigerer Preis überzeugt 44 Prozent, eine Promi-Stimme nur 38 Prozent und landet damit am Ende der Liste.
Der Blindtest: zwei Sieger
Die Ausschnitte deckten zwei Erzählsituationen ab. In der reinen Erzählpassage mit einem Sprecher lag die menschliche Einlesung in allen Kategorien vorn, bei der Narrationsqualität mit 65 zu 58 Prozent Topbewertungen, ebenso bei Gesamtpräferenz, Hörbereitschaft und Engagement. In der Dialogszene mit mehreren Figuren kehrte sich das Bild vollständig um. Hier gewann die KI-Version jede einzelne Kategorie, am deutlichsten beim Sprechen unterschiedlicher Geschlechter (65 zu 51 Prozent), aber auch bei Qualität, Figurendifferenzierung, Akzenten, Präferenz und Engagement.
Für die Kaufabsicht blieb das folgenlos. 46 Prozent der KI-Gruppe und 49 Prozent der Vergleichsgruppe gaben an, das Hörbuch nach dem Ausschnitt wahrscheinlich zu kaufen. Innerhalb der Fehlermarge ist das derselbe Wert.
Bemerkenswert ist die Trefferquote beim Erkennen: 61 Prozent derjenigen, die die KI-Fassung gehört hatten, hielten sie für menschlich. Umgekehrt stuften 35 Prozent der Hörer der menschlichen Einlesung diese fälschlich als KI ein.
Was die Offenlegung auslöst
Am Ende der Befragung erfuhr die KI-Gruppe, was sie gehört hatte. Vorher lag die allgemeine Bereitschaft, ein KI-produziertes Hörbuch zu hören, bei 31 Prozent. Unmittelbar nach dem Hören, aber noch ohne Kenntnis der Produktionsweise, sagten 65 Prozent, sie würden ein Hörbuch mit genau dieser Narration hören. Nach der Auflösung sank der Wert auf 41 Prozent, blieb damit aber ein Drittel über dem Ausgangsniveau. Die größten Zuwächse verzeichneten die skeptischsten Gruppen, Hörer ab 55 Jahren legten von 22 auf 35 Prozent zu, Frauen von 27 auf 39 Prozent.
Die offenen Antworten illustrieren den Effekt. Aus "klingt nicht authentisch" wurde "es gibt vermutlich welche, die ich hören kann", aus "völlig künstlich" wurde die Feststellung, man habe den Unterschied nicht gehört.
Einordnung
Die Studie vergleicht mehrstimmige KI mit einer Einzelsprecher-Produktion, nicht mit einer menschlichen Full-Cast-Aufnahme. Diese Kritik kam in der Fragerunde eines die Studie begleitenden Webinars mehrfach auf. Megan Lazovick von Edison begründete das Design mit dem Vergleich gegen den Marktstandard, Spoken-Gründer Philip Marshall zog die Parallele zur medizinischen Forschung, die stets gegen die etablierte Behandlung prüft. Michele Cobb (Forté Business Consulting, außerdem Executive Director der Audio Publishers Association), die die Q&A moderierte, verwies darauf, dass sich dieser Standard gerade verschiebt, Duett- und Multicast-Produktionen nehmen zu.
Weitere Grenzen benennt die Studie selbst. Bewertet wurden kurze Ausschnitte, nicht ein Hörbuch von dreizehneinhalb Stunden. Getestet wurde ein Titel in einem Genre. Für den deutschsprachigen Markt sind die Zahlen ohnehin nicht eins zu eins übertragbar.
Was bleibt, ist eine belastbare Momentaufnahme mit zwei praktischen Konsequenzen. Erstens: Mehrstimmigkeit ist ein Produktversprechen, das Hörer aktiv nachfragen, unabhängig von der Produktionsweise. Zweitens: Wer KI-Produktionen vermarktet, sollte über Qualität und Immersion sprechen, nicht über Ersparnis. Und die Kennzeichnung bleibt Pflicht. Die Transparenzleitlinien der Audio Publishers Association, entstanden gemeinsam mit Händlern, Verlagen und dem Spoken Word Committee der britischen Publishers Association, sind dafür der Referenzrahmen.